Guida tecnica a ipotesi statistiche, confronto delle medie e delle varianze, valori anomali ed equivalenza dei metodi, con formule ed esempi numerici.
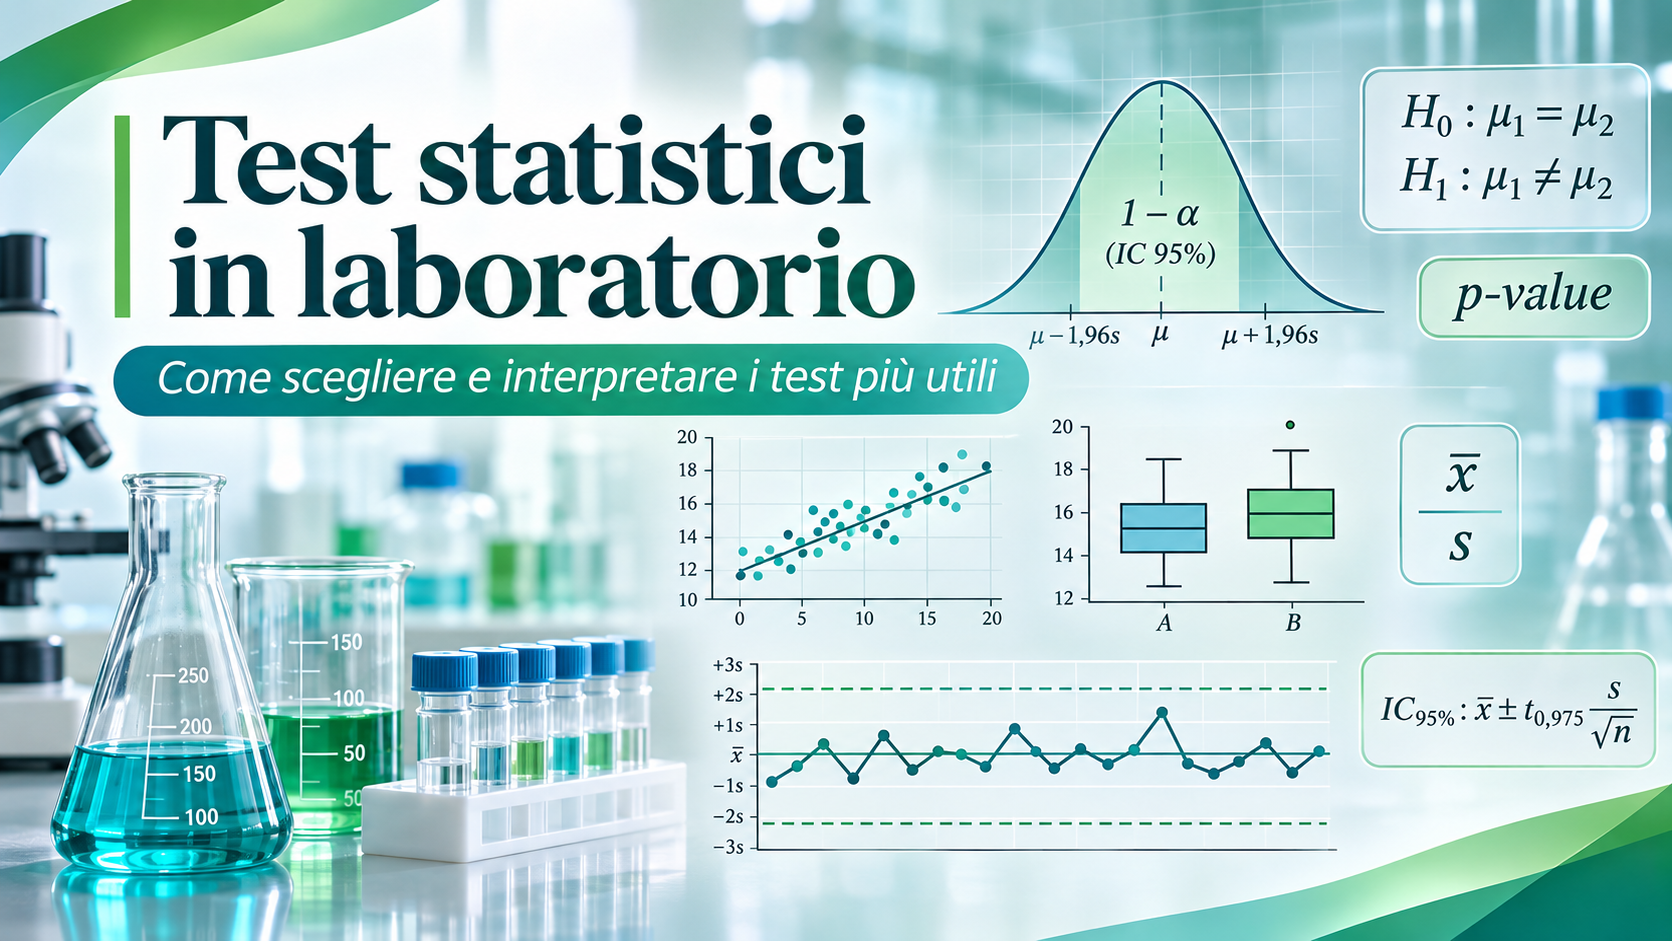
Due tecnici ottengono risultati differenti. È una differenza statisticamente significativa? Due serie di misure hanno precisioni confrontabili? È corretto eliminare un dato anomalo? Tre giornate di misura producono gli stessi risultati? In un laboratorio queste domande vanno affrontate con una procedura che tenga conto del disegno sperimentale, non scegliendo il primo test presente in un foglio di calcolo.
Un test statistico aiuta a quantificare quanta evidenza sperimentale esiste rispetto a una determinata ipotesi. Tuttavia, la significatività statistica non coincide con l’idoneità del metodo allo scopo. Quest’ultima richiede sempre un criterio di accettazione tecnico e metrologico.
Il punto centrale: un risultato con p maggiore di 0,05 non dimostra che due metodi siano uguali o equivalenti. Significa soltanto che, con quei dati e quel test, non abbiamo evidenza sufficiente per rifiutare l’ipotesi nulla al livello scelto.
1. Che cosa sono H₀, H₁, α e p-value?
Per una verifica di uguaglianza fra due medie la ipotesi nulla H₀ è, ad esempio, μ₁ = μ₂. La ipotesi alternativa H₁ può essere μ₁ ≠ μ₂ se interessa una qualsiasi differenza (test bilaterale), oppure μ₁ > μ₂ se la domanda è direzionale e questa ipotesi è stata definita prima della raccolta dei dati.
Il livello di significatività α, frequentemente pari a 0,05, definisce il rischio massimo prefissato di rifiutare H₀ quando H₀ è vera. Il p-value rappresenta invece la probabilità, assumendo vera H₀ e valido il modello statistico, di osservare una statistica almeno altrettanto estrema di quella calcolata.
Se p ≤ α, si rifiuta H₀ al livello stabilito. Se p > α, non si rifiuta H₀: non si può concludere che H₀ sia stata dimostrata. È opportuno esaminare anche dimensione dell’effetto, intervallo di confidenza, numerosità e potenza statistica, soprattutto se il risultato è vicino alla soglia.
2. Come scegliere il test statistico
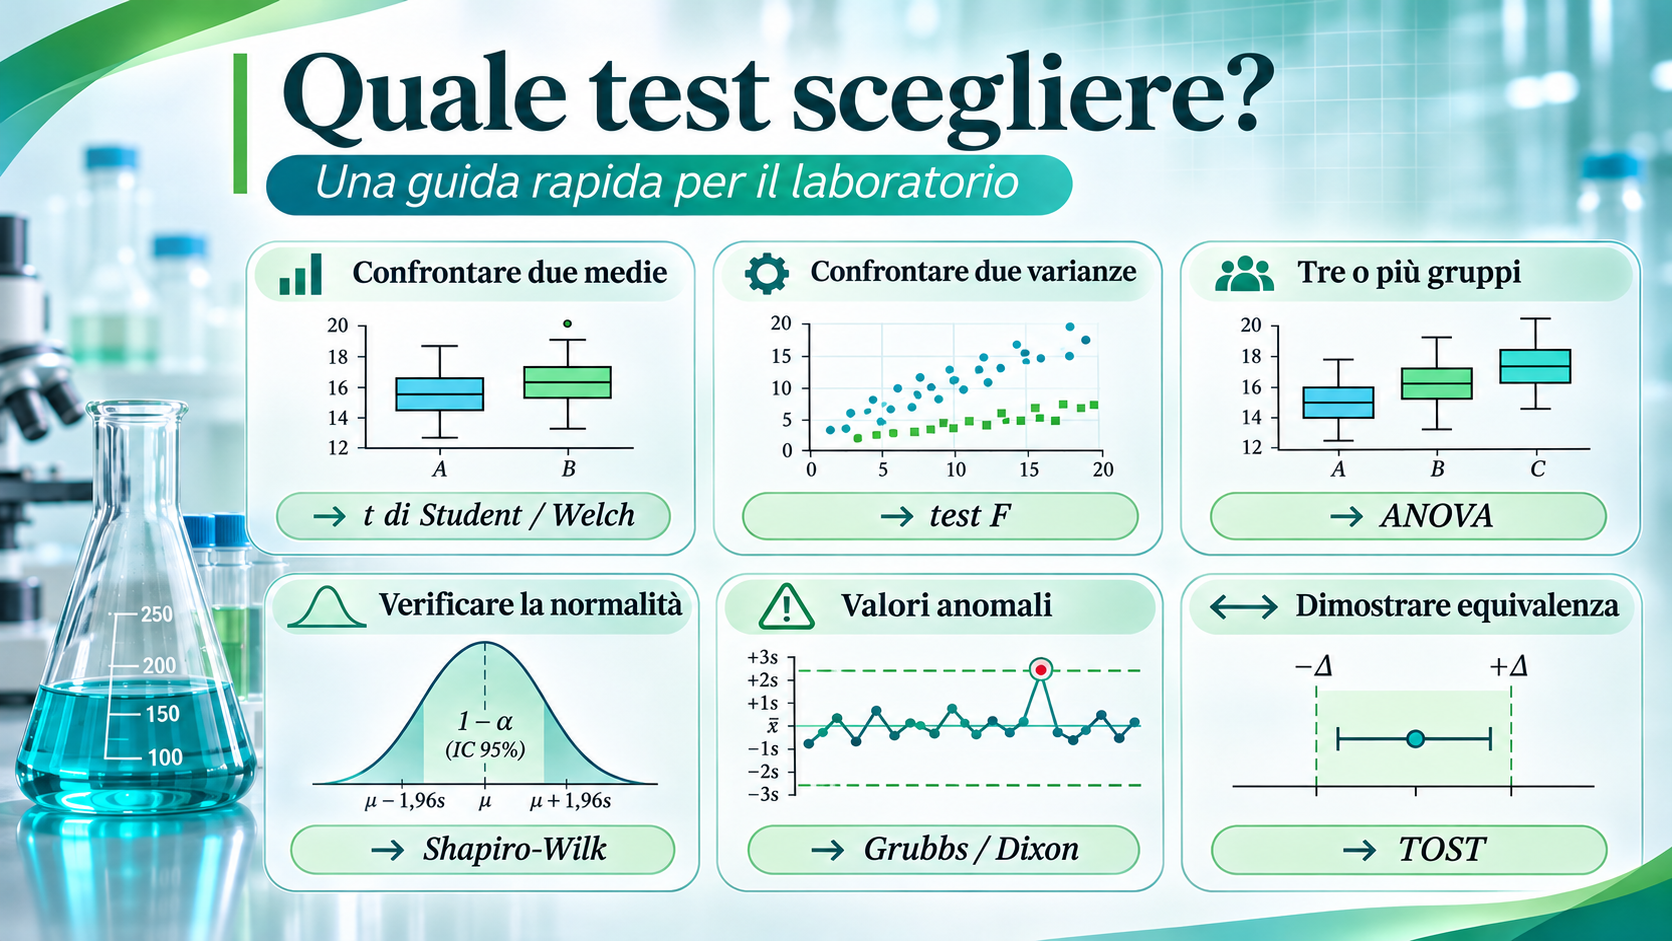
L’infografica è illustrativa. Nelle curve normali il tratto μ ± 1,96σ rappresenta approssimativamente il 95% della distribuzione, non l’intervallo di confidenza al 95% della media. Quest’ultimo dipende dall’errore standard e, con scarto tipo stimato, dalla distribuzione t.
| Domanda del laboratorio | Test da valutare | Elementi preliminari |
|---|---|---|
| Una media rispetto a un riferimento | t a un campione | Indipendenza, compatibilità con normalità, natura del riferimento |
| Due medie su gruppi indipendenti | Welch, oppure Student a varianza comune | Indipendenza, dispersione, distribuzioni |
| Due risultati sullo stesso campione | t appaiato | Differenze per coppia, normalità delle differenze |
| Due varianze di serie indipendenti | F di Fisher | Normalità dei dati e disegno sperimentale |
| Tre o più gruppi | ANOVA o Welch ANOVA | Indipendenza, residui, omogeneità delle varianze |
| Compatibilità con la normalità | Shapiro–Wilk | Numerosità e grafici diagnostici |
| Presenza di un dato estremo | Grubbs o Dixon, se applicabili | Ipotesi del test, indagine tecnica, più outlier |
| Equivalenza entro un margine | TOST | Margini di equivalenza tecnici stabiliti prima |
3. Test t a un campione: una media differisce dal valore di riferimento?
Immaginiamo un materiale di riferimento con valore assegnato μ₀ = 10,00 mg/L. Il laboratorio realizza n = 10 misure indipendenti, ottenendo media x̄ = 10,14 mg/L e scarto tipo campionario s = 0,20 mg/L.
Per un test bilaterale: H₀: μ = 10,00 mg/L; H₁: μ ≠ 10,00 mg/L. La statistica vale:
t = (x̄ − μ₀)/(s/√n) = (10,14 − 10,00)/(0,20/√10) = 2,214
I gradi di libertà sono 9. Per α = 0,05, il valore critico bilaterale è circa 2,262 e il p-value vale 0,0541. In questo esempio non si rifiuta H₀ al 5%. Ciò non dimostra che il bias sia nullo: la differenza misurata e la sua incertezza devono comunque essere confrontate con un requisito tecnico. La valutazione del bias di metodo richiede inoltre attenzione alla riferibilità e all’incertezza del valore assegnato.
4. Student, Welch e dati appaiati
Supponiamo che due gruppi indipendenti producano: A: n₁ = 10, x̄₁ = 10,2 mg/L, s₁ = 0,3 mg/L e B: n₂ = 10, x̄₂ = 10,6 mg/L, s₂ = 0,4 mg/L.
Per il test di Welch, che non richiede di assumere uguali le varianze:
t = (x̄₁ − x̄₂)/√(s₁²/n₁ + s₂²/n₂) = −2,530
Con gradi di libertà stimati tramite Welch–Satterthwaite pari a 16,69, il p-value bilaterale è circa 0,0218. A α = 0,05 si osserva dunque una differenza statisticamente significativa fra le medie, assumendo soddisfatti gli altri presupposti.
Il test t di Student per campioni indipendenti con varianza comune utilizza lo scarto tipo pooled. Può essere appropriato se l’ipotesi di varianza comune è giustificata dal disegno e dalla conoscenza del processo. Non è raccomandabile scegliere in maniera meccanica Student o Welch soltanto in funzione di un test F preliminare.
Quando i dati sono appaiati
Se gli stessi dieci campioni sono misurati con due procedure, le osservazioni non sono indipendenti tra i metodi. Si definisce per ogni campione dᵢ = risultato Aᵢ − risultato Bᵢ e si applica un t a un campione alle differenze: t = d̄/(s_d/√n). In questo caso bisogna valutare la distribuzione delle differenze, la possibilità di un bias proporzionale e l’effettiva corrispondenza delle coppie.
5. Test F: confronto tra due scarti tipo
La statistica del test F classico è il rapporto delle varianze: F = s₁²/s₂², con gradi di libertà n₁ − 1 e n₂ − 1. Il test è particolarmente sensibile alle violazioni della normalità e assume serie indipendenti.
Per due serie di 10 misure ciascuna, con s₁ = 0,45 mg/L e s₂ = 0,30 mg/L, ponendo la varianza maggiore al numeratore si ottiene F = 0,45²/0,30² = 2,25. Nel confronto bilaterale con 9 e 9 gradi di libertà, il p-value è 0,2428. Non emerge una differenza statisticamente significativa delle varianze al livello 0,05.
Questo non prova che le precisioni siano identiche o tecnicamente accettabili. La loro adeguatezza si valuta rispetto alla precisione attesa, alle specifiche del metodo, alla concentrazione e all’uso dei risultati. Per distribuzioni non normali, ove appropriato, si possono valutare procedure più robuste come Levene o Brown–Forsythe.
6. ANOVA: più operatori, giornate o condizioni sperimentali
Quando i gruppi sono tre o più, effettuare numerosi t-test separati aumenta la probabilità di falsi positivi. L’ANOVA a una via confronta la variabilità fra i gruppi con quella entro i gruppi:
F = MS(fra gruppi) / MS(entro gruppi)
Consideriamo tre gruppi didattici di risultati in mg/L:
- A: 10, 11, 9, 10 — media 10;
- B: 11, 12, 10, 11 — media 11;
- C: 13, 14, 12, 13 — media 13.
Il calcolo restituisce F(2, 9) = 14,00 e p = 0,00173. Esiste evidenza che non tutte le medie siano uguali. Il risultato non indica però quali coppie differiscono; per questo si applicano confronti post-hoc appropriati, con correzione per confronti multipli.
Attenzione: in uno studio di precisione con operatori, giornate e strumenti i fattori possono essere incrociati, annidati o a effetti casuali. Per stimare le componenti di varianza e la precisione intermedia occorre utilizzare un modello che rispecchi il disegno sperimentale. Una ANOVA a una via non è automaticamente adeguata.
7. Shapiro–Wilk: i dati sono normali?
Il test di Shapiro–Wilk verifica l’ipotesi nulla secondo cui i dati provengono da una distribuzione normale. Un p-value piccolo fornisce evidenza contro la normalità; un p-value elevato non la dimostra. Con pochi dati, il test ha capacità limitata di rilevare scostamenti; con grandi quantità di dati può rilevare scostamenti di limitata rilevanza pratica.
Affiancare Q–Q plot, istogramma, osservazione degli estremi e conoscenza del processo. Per il t appaiato interessa la normalità delle differenze; nell’ANOVA quella dei residui del modello. Un risultato vicino al LOQ, censurato o fortemente asimmetrico può richiedere approcci alternativi o una trasformazione motivata.
8. Grubbs e Dixon: i valori anomali
Il test di Grubbs è pensato per individuare un singolo possibile dato anomalo in una serie univariata approssimativamente normale. Si basa sulla statistica G = max|xᵢ − x̄|/s. Il test di Dixon si applica in specifiche condizioni, generalmente a piccoli insiemi di dati ordinati, e valuta un rapporto che coinvolge il gap estremo e il campo di variazione.
Un valore statisticamente anomalo non deve essere cancellato automaticamente. Il laboratorio deve verificare preliminarmente anomalie di preparazione, diluizione, trascrizione, misura, taratura, contaminazione o deriva, e registrare eventuali cause assegnabili. In presenza di più valori estremi il Grubbs singolo può non essere appropriato. L’esclusione di un dato deve essere motivata in termini tecnici, non soltanto statistici.
9. TOST: quando occorre dimostrare equivalenza
Un t-test tradizionale indaga una differenza da zero. Se lo scopo è stabilire se la differenza fra due metodi è sufficientemente piccola per un uso specifico, si definiscono prima i margini tecnicamente accettabili −Δ e +Δ e si valuta un test di equivalenza, come il TOST.
Con un livello di significatività α = 0,05, un’impostazione bilaterale TOST può essere interpretata tramite un intervallo di confidenza al 90% della differenza: per concludere a favore dell’equivalenza, l’intero intervallo deve risultare contenuto tra i margini prestabiliti.
Esempio: differenza stimata 0,8 mg/L, IC al 90% [−0,1; 1,7] mg/L, margine ±2,0 mg/L. Poiché l’intervallo è interamente dentro i margini, i dati sostengono l’equivalenza relativamente a quei limiti, purché modello e disegno siano validi. La scelta di ±2,0 mg/L deve comunque essere giustificata tecnicamente.
Per un approfondimento con esempio numerico completo, consulta l’articolo DN sui test TOST nei laboratori ISO/IEC 17025.
10. Che cosa documentare in uno studio statistico
- Obiettivo della decisione: confronto, verifica prestazionale o equivalenza.
- Dati e progettazione: matrice, livello di concentrazione, numero di prove, operatori, giornate, indipendenza e appaiamento.
- Ipotesi e livello α: H₀, H₁ e test bilaterale o unilaterale definiti preventivamente.
- Assunti verificati: distribuzione, indipendenza, omogeneità delle varianze e diagnostiche pertinenti.
- Risultati: statistica, gradi di libertà, p-value, intervalli di confidenza e grandezza dell’effetto quando rilevanti.
- Criterio tecnico: conclusione sulla idoneità allo scopo, distinta dalla significatività statistica.
- Rintracciabilità: dati grezzi, fogli di calcolo, versione del software e verifiche indipendenti.
La ISO/IEC 17025 richiede adeguatezza e validità delle attività, ma non impone indistintamente uno specifico test statistico per tutte le situazioni. È responsabilità del laboratorio individuare un approccio pertinente al metodo e documentarne il fondamento.
Approfondimenti e riferimenti
- Eurachem, The Fitness for Purpose of Analytical Methods, 3ª edizione, 2025.
- Eurachem, The Two One-Sided t-Test, 2026.
- NIST, Two-Sample t-Test.
- NIST, Test F.
- NIST, ANOVA a una via.
- NIST, Test di Grubbs per dati anomali.
- DN Consulenze: ripetibilità a più livelli.
- DN Consulenze: strumenti statistici online.
Hai bisogno di definire un protocollo statistico per un metodo di prova, una verifica di precisione o un confronto fra risultati? Approfondisci le risorse DN sulla validazione dei metodi ISO/IEC 17025 e sul controllo qualità statistico. Per sottoporre un caso concreto, invia una richiesta preliminare indicando matrice, metodo e obiettivo. Ogni eventuale incarico è subordinato alla verifica di compatibilità e imparzialità.